笔记本跑7000亿参数GLM!无GPU也行? SSD当显存用火爆GitHub
📝 内容摘要
开源项目 Colibrì 用「SSD 当显存」的分层推理,让笔记本也能跑 7000 亿参数的大模型,已揽 32k Star。速览其原理、性能与上手门槛。
📌 核心要点
- 开源项目 Colibrì 用「SSD 当显存」的分层推理,让 12 核 CPU + 25GB 内存的笔记本也能跑 744B 的 GLM-5.2,已揽 32k Star
- MoE 每 token 只激活约 40B 参数,把用不上的路由专家(约 370GB)扔进 NVMe SSD,常驻 RAM 的只有约 9.9GB 的 Dense 部分
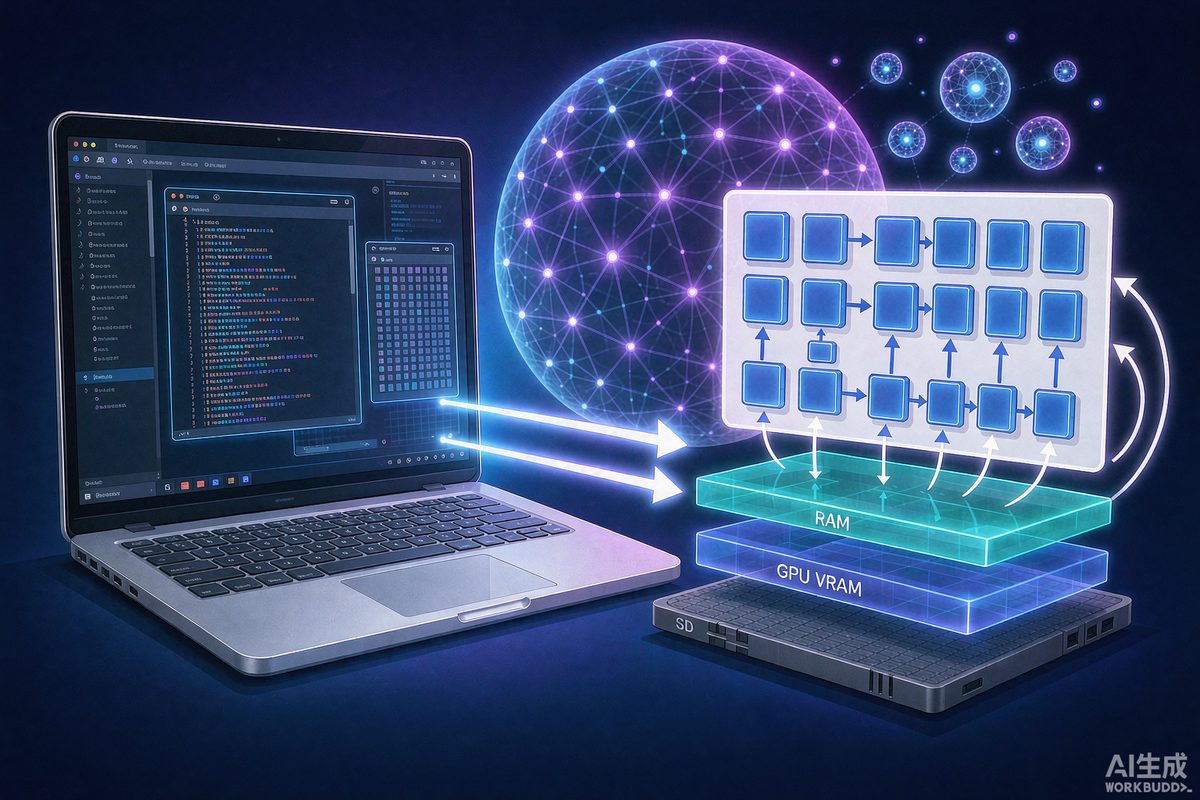
- 靠 LRU 缓存 + 提前一层预测专家(可预测性 71.6%)+ 多 SSD 并行,把 SSD/RAM/VRAM 做成分级「显存」
开源项目 Colibrì 用「SSD 当显存」的分层推理,让 12 核 CPU + 25GB 内存的笔记本也能跑 744B 的 GLM-5.2,已揽 32k Star。
是什么
纯 C、零引擎依赖的分层推理框架;最早为 GLM-5.2 而生,现覆盖 9 个模型家族(DeepSeek V4 Flash / Qwen / Inkling 975B / Kimi K3 2.8T 等)。
怎么做到的
MoE 每 token 只激活约 40B 参数,把用不上的路由专家(约 370GB)扔进 NVMe SSD,常驻 RAM 的只有约 9.9GB 的 Dense 部分。
性能表现
靠 LRU 缓存 + 提前一层预测专家(可预测性 71.6%)+ 多 SSD 并行,把 SSD/RAM/VRAM 做成分级「显存」。纯 CPU 128GB 约 1.8 token/s;6×RTX 5090 可达 5.8–6.8 token/s。
上手门槛
跑 GLM-5.2 需约 372GB 模型 + 几百 KB 程序;Kimi K3 需约 1.6TB 空间但 32GB 内存即可起跑,都不强制 GPU。
项目:github.com/JustVugg/colibri
打开微信「扫一扫」,分享给好友或朋友圈
关闭